
画面稍微糊一点,观众通常能忍。声音发闷、配乐不对,或者干脆没声音,用户会直接划走。音频往往是一条产品视频最后才加的部分,却是观众最先注意到的部分。
这篇教程讲怎么用 KreadoAI 的 AI 音频工具补齐这一层。AI 音频工具,是根据文字描述或你上传的录音来生成、转换声音的工具。KreadoAI 目前有四个:AI 音乐生成器负责歌曲和背景音乐,AI 音效生成器负责短音效,AI 变声处理已经录好的人声,AI 语音转文字负责出文字稿和 SRT 字幕。四个工具各自独立,结果下载后,由你自己放进剪辑软件。
下面会讲每个工具做什么、什么时候用、具体怎么操作,每个工具附一段真实输出,最后给一条把四个工具串起来的产品视频流程。
先选对工具:你需要哪一个 AI 音频工具?
从手上已有的东西出发。手里只有想法、没有音频,用两个生成器;手里已经有录音,用 AI 变声或语音转文字。
| 你手上有 | 你想要 | 用哪个 KreadoAI 工具 | 得到什么 |
|---|---|---|---|
| 一段描述氛围的文字 | 歌曲或背景音乐 | AI 音乐生成器 | MP3、WAV 或 FLAC |
| 一段描述声音的文字 | 转场、撞击、环境声或界面提示音 | AI 音效生成器 | MP3 或 WAV |
| 一段录好的口播 | 同样的话,换一种声音 | AI 变声 | 新的音频文件 |
| 音频文件或 MP4 | 文字稿和字幕 | AI 语音转文字 | 文字 + SRT 字幕 |
| 一份写好的稿子 | 一条全新的配音 | 文字转语音 | 生成的配音 |
最后一行不属于本文讲的四个音频工具,但后面的流程会用到。文字转语音从你输入的文字出发,AI 变声从你录好的声音出发。
1. 用 AI 音乐生成器为视频生成配乐
AI 音乐生成器根据文字描述生成音乐。它能做两件不同的事,选对其中一件,就完成了一大半。
歌曲带 AI 写的歌词和人声,按你的描述生成。背景音乐是纯器乐,垫在口播、字幕或产品演示下面。只要视频里有人说话,基本都该选背景音乐,带人声的歌会和口播抢耳朵。
怎么生成音乐
- 打开 AI 音乐生成器,进入音乐生成。
- 选模型。菜单里目前有 Mureka v9.5(Prompt to Song)用来生成歌曲,Lyria 3.5 和 Mureka v9.5(Background Music)用来生成纯音乐。
- 描述音乐:风格、情绪、速度、乐器,以及它要垫在什么画面下面。“柔和钢琴,慢速,用于护肤演示,给口播留空间”比“放松的音乐”好用得多。
- 选 MP3、WAV 或 FLAC,然后提交。
- 在历史记录里试听。点重新生成,会用同一段描述再出一版;方向不对时,改描述比反复重试更有效。
- 下载满意的那版,拖进时间线。
音乐生成器不会读取你上传的视频来自动配乐。音乐从哪里进、用多长,由你在剪辑里决定。
下面是生成器产出的一段纯音乐样例,标签是产品演示、柔和、钢琴:
AI 配乐适合放在哪
- 产品演示和功能讲解:垫一段纯音乐,讲解听起来不吃力。
- 社交媒体短广告:按剪辑节奏选明快或安静的音乐,再裁到帖子时长。
- 品牌短片:没人说话、音乐本身就是表达时,用歌曲更合适。
2. 用 AI 音效生成器做自定义音效
AI 音效生成器把一段文字描述变成一个短音频。它负责让画面里的动作“有分量”:镜头切换时的风声、标题落下时的重击、安静画面后面的雨声、手指点手机屏幕的那一下。
怎么生成音效
- 打开 AI 音效生成器,进入音效生成。
- 选模型。菜单里目前有 Seed Audio v1.0 Sound Effects 和 ElevenLabs Sound Effects。
- 一次只描述一个声音:什么东西发出的、经过什么材质、离得多近、周围是什么氛围。例如“很近的玻璃泵头按压声,干净,用于护肤演示”。
- 选 MP3 或 WAV,提交。
- 在历史记录里试听,可以重新生成另一版,也可以直接下载。
一条描述只写一个声音,这条规则最省时间。同时要风声、撞击和人群声,结果容易糊成一团。分开生成,再在剪辑里叠起来。
这是生成器产出的一段 15 秒产品音效:饮料倒进玻璃杯。
创作者一般怎么用音效
- 转场:镜头切换时一声轻柔的风声。
- 撞击:结尾卡出现产品名时垫一下重击。
- 环境声:窗上的雨、海边的浪,交代场景在哪里。
- 产品和界面音:拧瓶盖、按泵头、点一下确认下单。
和音乐生成器一样,音效不会自动对齐你上传的视频。每个音效放在哪一帧,由你来定。
3. 用 AI 变声改变已有录音的声音
AI 变声处理的是你已经录好的音频,输出同一段话、换了另一种声音的新文件。用词和停顿都保留,只换声音。
所以它和两个常被混淆的工具不一样。文字转语音从稿子出发,生成一条新的朗读;声音克隆是用一段样本做出一个可复用的声音,属于单独的步骤。AI 变声必须先有录音,适合“说法已经对了,只想换个人来说”的情况。
怎么变声
- 打开 AI 变声,上传音频。可以点上传框,也可以把文件拖进去。
- 选目标声音。选择面板有两个标签:系统音色和克隆音色。选中一个,点应用。
- 开始转换。
- 试听结果,下载,再放到时间线上。
已公开的说明里,单段录音最长五分钟。如果页面上显示的限制不同,以页面为准。更长的文件,先切开再上传。
下面是产品页用到的一段原始录音,一条简短的精华口播:
同一段录音,转换成更低沉的声音之后:
注意听停顿的位置,两版是对得上的。所以你可以直接把新文件换进已经剪好的片子里,不用重新剪画面。
实际用法
- 第二个角色:一个人录两句台词,其中一句换成另一种声音。
- 系列广告统一声音:每一条都用同一个目标音色,一组广告听起来是同一个人在说。
- 同一段卖点换个更温暖或更清晰的声音,不用再约一次录音。
AI 变声只处理保存好的文件。它不是游戏、通话或直播里的实时变声麦克风,也不会模仿某个具名的人。
4. 用 AI 语音转文字把音频和视频转成文字
AI 语音转文字把音频文件或 MP4 里的讲话转成可编辑的文字。上传 MP4 时,工具先抽出音轨,再做转写。它会自动识别说话的语种,原文旁边附中文译文,还可以导出带时间轴的 SRT 字幕。
转写模型是 Gemini 3.5 Transcribe。Google 对这个模型的官方文档列出的支持语言超过 85 种。
怎么把音频或 MP4 转成文字
- 打开 AI 语音转文字,在本地上传里点击上传区,或把音频文件拖进去。也可以上传 MP4。
- 确认转写模型是 Gemini 3.5 Transcribe,点击开始转写。不需要先选语种。
- 查看结果。原文和中文译文逐句对照显示。
- 按需要选:复制全部、只复制原文、只复制译文,或导出 SRT。
- 把 SRT 导入剪辑软件的字幕轨,或者把文字贴进你的脚本文档。
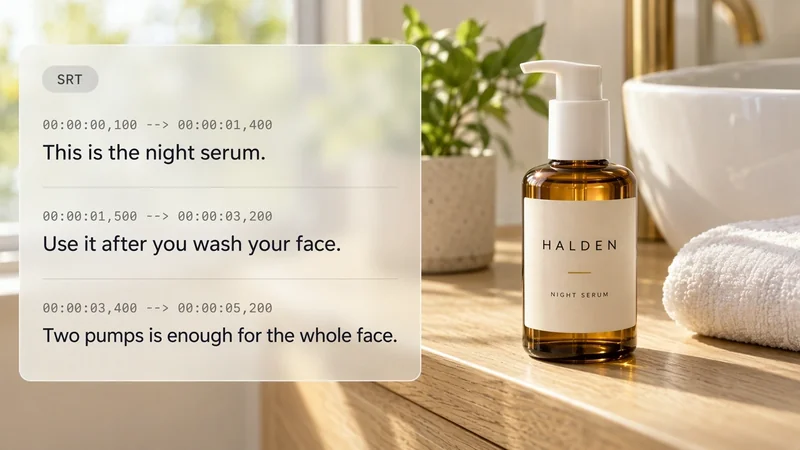
看一个真实例子。这段 17 秒的英语产品口播:
导出的 SRT 开头是这样的:
1 00:00:00,100 --> 00:00:01,400 This is the night serum.
2 00:00:01,500 --> 00:00:03,200 Use it after you wash your face.
3 00:00:03,400 --> 00:00:05,200 Two pumps is enough for the whole face.
4 00:00:05,400 --> 00:00:07,100 Press it in, then leave it on.
它不做什么
它不会把字幕压进视频。原来的 MP4 保持不变,字幕以单独的 SRT 文件或复制的文字给你。它也不接受视频链接或 YouTube 地址,需要上传文件。除音频文件和 MP4 以外的格式暂不支持,文件大小上限以上传页面的提示为准。
5. 用文字转语音把稿子读成配音
文字转语音从你输入的文字出发,生成一条新配音。稿子已经写好、手里没有录音,或者上一步的转写稿改过了,就用它。它不是 AI 变声。AI 变声保留已有录音的原话和停顿;文字转语音是按稿子从头演一遍,语气怎么走由你来定。
用文字转语音生成配音的步骤
- 打开文字转语音,粘贴稿子。产品名保持原样,稿子的语言与观众要听到的一致。
- 选音色。音色列表里有 MiniMax Speech-2.8-HD、ElevenLabs Eleven v3、Gemini 3.1 Flash TTS 和豆包音色。如果你用声音克隆做过自己的音色,也可以在这里选;克隆本身是单独的一步。
- 用情绪标签指导语气。可以先让 AI 自动加一遍,再手动修改、复制或删除。
- 生成后先试听,再下载音频。字幕文件可以和音频一起生成、下载。
- 把配音放到时间线上,再用前面的工具补上配乐和音效。
用情绪标签控制语气和停顿
情绪标签是写在方括号里的提示,例如 [excited]、[happy]、[whispers]、[laughs]、[pause]。模型会把它们演出来,而不是念出来。一条 15 秒的精华广告,加了标签的稿子大概是这样:
[excited] 晚安精华回来了。[pause] 洗完脸按两下。[whispers] 然后就不用管了。
标签少放几个,放在真正卖货的地方:开头的钩子、卖点、最后的行动号召。不是每个标签都适合每个音色,太轻柔的音色可能会忽略 [shout] 这类标签。整段生成前,先拿一句带标签的台词试听。想进一步了解音色模型和标签,可以看 KreadoAI AI 配音升级介绍。
四个新工具怎么配合:一条产品视频的音频流程
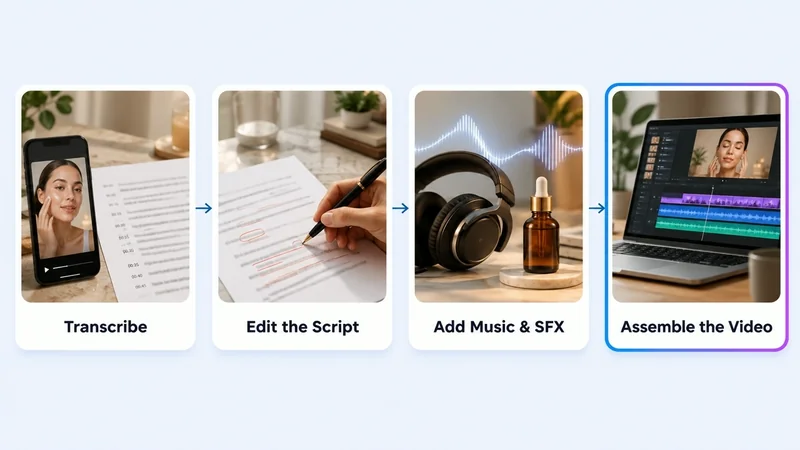
四个工具之间不会自动传文件,每一步的结果都要你手动带到下一步。听起来慢,实际并不麻烦。下面是一条 20 到 30 秒、从已有录音出发的产品广告,我们会按这个顺序来做。
第 1 步:转写已有的录音
把原始口播或 MP4 放进 AI 语音转文字。你会拿到准确的原话、时间轴,需要做中文版时还有中文译文。这一步就把 SRT 导出来,后面做字幕要用。
第 2 步:修改转写稿
把原文复制到脚本文档里。收紧开头的钩子,删掉多余的句子,改正产品名。在这里改内容,成本最低。
第 3 步:拿到最终配音
看改动有多大,分两种情况。如果台词没变,只想换个人来说,把原始录音上传到 AI 变声。如果稿子重写了,就用文字转语音根据新稿生成一条新配音。
第 4 步:生成背景音乐
描述一段给人声留空间的音乐。如果成片需要更大的文件,下载 WAV。
第 5 步:生成音效
列出需要点缀的时刻:第一个剪辑点、产品亮相、结尾卡。每个时刻生成一个音效。
第 6 步:在剪辑软件里合成成片
先放配音,再把音乐垫在下面,最后把音效放到对应的帧上。导入 SRT 做字幕。如果稿子重写过,把新配音再过一遍语音转文字,字幕时间轴才能和新的朗读对上。
使用 AI 音频工具的常见错误
- 口播下面垫带人声的歌。人声会和口播抢,换成背景音乐模型。
- 一条音效描述里写好几个声音。拆成几条分别生成,再叠在一起。
- 指望 AI 变声改稿子。它保留原话和停顿。要改稿子,用文字转语音。
- 上传有噪音或爆音的录音。AI 变声和语音转文字都只能跟着听得清的部分走。某个词听不清时,重新录一条干净的。
- 把 SRT 当成压进画面的字幕。它是单独的字幕文件,需要导入剪辑软件,或在支持的平台上随视频一起上传。
- 换了新配音还用旧的 SRT。旧时间轴来自旧的朗读,新文件要重新转写。
常见问题
KreadoAI 的 AI 音频工具有哪些?
一共四个独立工具:AI 音乐生成器、AI 音效生成器、AI 变声和 AI 语音转文字。两个生成器根据文字描述生成音频,AI 变声和语音转文字处理你上传的录音。
怎么用 AI 生成音乐?
打开 AI 音乐生成器,选歌曲模型或背景音乐模型,写清风格、情绪、速度和画面,选 MP3、WAV 或 FLAC 后提交。在历史记录里试听,满意后下载。
可以用文字生成音效吗?
可以。描述一个声音,比如转场风声、撞击、环境声或产品按压声,选 MP3 或 WAV 后生成。同一段描述可以重新生成另一版。
可以改变已有录音的声音吗?
可以。把录音上传到 AI 变声,选系统音色或克隆音色,开始转换。原话和停顿保持不变,你会得到一个新的音频文件。
可以把音频和视频转成文字吗?
可以,支持音频文件和 MP4 视频。AI 语音转文字会自动识别语种,显示原文和中文译文,可以复制文字或导出 SRT。暂不支持视频链接。
语音转文字和文字转语音有什么区别?
语音转文字从录音出发,得到文字和字幕。文字转语音从稿子出发,生成新的配音。同一个项目里经常一前一后都会用到。
我的视频该用哪个音频工具?
要配乐用音乐生成器,要短促的点缀和环境声用音效生成器,录音不错但想换个声音用 AI 变声,需要录音里的原话或字幕用语音转文字。
总结
KreadoAI 的每个音频工具负责视频声音的一个环节:语音转文字从录音里取出原话和字幕,AI 变声替换说话人,音乐和音效生成器补上人声下面和周围的声音。四个工具一个一个用,最后在你自己的剪辑软件里完成混音。想了解这几个工具的产品层面介绍,可以看 KreadoAI 新上线的 AI 音频工具。